
「白天的話說給不認識的人聽,所以囉嗦、留餘地、經得起回頭查。夜裡的手勢只給早就講好暗號的人,三根手指就是一條人命。」
——《阿帕契開源審計錄》¹ 卷二·暗號篇
幕間
狼窩只剩兩人。三號出局後,敘事者問:「接下來怎麼打?」
二號沉默良久:「你說了算。」
敘事者忽然心頭一驚:從開局至今,狼隊所有決定全是他或三號拍板,二號竟從未主動提議過一次。
七號在羊皮紙上拉了兩欄。左邊抄白天的公開發言:誰指控誰、用了什麼理由、留了什麼活口的說法,一整段一整段,任何人事後翻回來都讀得懂,因為每句話都自帶主詞、時間、對象。右邊記夜裡發生的事——可是夜裡沒有遺言,倒牌是安靜的,她只能從「今晚誰死了、誰還在」反推。右欄幾乎沒有字,只有結果,而且看不懂:那幾個死者的座號排在一起,除非你本來就知道狼隊今晚約好要對付神職、還是要平推平民,否則毫無意義。她把兩欄擺在一起看了很久,說:「白天講一大串才傳得出一件事,夜裡三個動作就結束一輪。同樣是溝通,為什麼一邊要一整段話、一邊只要幾個手勢?」二號先是把她那句「一邊只要幾個手勢」照著覆誦了一次,才慢慢接話說夜裡的效率確實可疑、值得記下來。就在他接話時,穹頂上「上帝的聲音」補了一句發言時限的提醒——那一句的語氣跟平時敲法槌的官腔不太一樣,像同一張嘴後面換了個人在講。七號抬頭看了一眼,沒作聲,在羊皮紙邊上多記了一筆。而她提的那個問題,其實就是今天要拆的東西:REST 和 gRPC,同一次呼叫,為什麼線上傳的位元組數差這麼多?代價又各自是什麼?
REST 把系統操作對應到資源和 HTTP 方法,內容通常是 JSON。它每一個特徵都指向「說給不特定對象聽」:欄位名跟著資料一起送,所以是自描述的,收到的人不必先拿到一份文件就能猜出這是什麼;純文字,人類直接讀得懂,curl 一行就能打,出事時你把回應貼進聊天室大家都看得懂;每次請求原則上獨立,伺服端不必記得你上一句話(無狀態),這也是為什麼白天發言就算被打斷,法官也不必記住每個人上一輪講到哪——每次投票、每次指控都是一個帶完整上下文的全新請求。代價是冗長:{"target_id": 2} 這一小段,光是 target_id 這個欄位名和引號、大括號就佔掉大半,真正的資訊只有一個 2。
gRPC 反過來。雙方事先用一份 .proto 檔講好每個欄位叫什麼、什麼型別、對應哪個「欄位編號」,之後上線傳的只有編號加值,二進位,沒有欄位名。少了那份 schema,你連怎麼把位元組切成一個個欄位都做不到——這正是狼隊暗號的模型:暗號本身壓到極限,前提是所有人先背過同一張對照表。
// The schema both sides must agree on beforehand -- the pack's hand-signs.
syntax = "proto3";

message NightAction {
  uint32 actor_id  = 1;   // on the wire: tag 1 + a varint, no field name
  uint32 target_id = 2;   // tag 2
  ActionKind kind  = 3;
}

enum ActionKind { KILL = 0; SAVE = 1; POISON = 2; }
這份 .proto 裡真正關鍵、也是大型專案裡唯一難改對的部分,是那幾個 = 1、= 2、= 3。欄位編號一旦上線就等於永久契約:新增欄位一定要給新的、沒用過的編號,絕不能重用刪掉的舊編號,改型別的規則也很嚴。做對了,五年前用舊 schema 編譯的服務可以無痛跟今天的新服務通訊——舊服務看到不認得的編號就跳過,新服務給缺席的欄位補預設值。做錯了——比方把 target_id 的編號從 2 改成 4——舊服務會把新資料裡的 4 號欄位當成陌生欄位丟掉,然後拿著空的 target_id 繼續跑,不會報錯,只會默默做錯事。JSON 沒有這個包袱(欄位靠名字對,改名字至少會炸得很明顯),但也因此永遠省不掉把欄位名重複塞進每一筆回應的成本。
這兩種格式在 CPU 上的代價也不同。解析 JSON 要逐字元掃描:找引號、處理跳脫字元、判斷數字邊界、配置字串物件、建一棵樹或一張 map,再從裡面按名字撈欄位——一個中等大小的 JSON 回應,這些動作加起來並不便宜,高流量服務常常花可觀的 CPU 只在 JSON 進出上。Protobuf 解碼是讀一個 varint 拿到「欄位編號加線型」,然後照 schema 已知的型別直接讀固定或變長的位元組進結構欄位,沒有掃描、沒有猜測、幾乎沒有中間物件。varint 本身是個小聰明:小的數字用一個位元組,每個位元組拿 7 位存值、1 位當「還有沒有下一個位元組」的旗標,所以 2 就是一個位元組,狼隊常用的座號都落在一兩個位元組內。
白天的發言是 HTTP/1.1 式的:一條連線同一時間只處理一個請求,前一個回應還沒送完,後面的請求就得在這條連線上排隊——這就是「隊頭阻塞」。夜裡的暗號走 HTTP/2:一條連線切成很多個「串流」,各自獨立來回,標頭還會用 HPACK 壓縮,所以狼隊可以在同一條夜間連線裡連續交換好幾輪訊息,不必每輪重新握手,狀態也延續得下去。要注意 HTTP/2 只在它那一層消掉了隊頭阻塞——底下還是單一條 TCP 連線,一旦某個 TCP 封包掉了,作業系統會擋住後面所有已經到達的資料等重傳,這時候所有串流一起卡住。真正在傳輸層也解決這件事的是 HTTP/3(改用 QUIC),但那是另一天的題目。
net/http 直接做 REST 的兩端;gRPC 用 google.golang.org/grpc,.proto 經 protoc 產生 stub。java.net.http.HttpClient 或框架做 REST;grpc-java 做 gRPC。Kafka 這種系統內部走自訂二進位協定,動機和選 gRPC 一樣——高頻、對端固定、省不起文字開銷。httpx 或 requests 打 REST;gRPC 用 grpcio 加 protobuf,注意純 Python 的序列化較慢,重負載通常靠 C 擴充。reqwest 打 REST;tonic(建在 tokio 上)做 gRPC,schema 由 prost 產生對應的結構。# REST/JSON client -- self-describing, readable on the wire, verbose
import httpx
resp = httpx.get("https://village-api.example.com/players/7", timeout=5)
if resp.status_code == 200:
player = resp.json() # {"id": 7, "alive": true, "role_claim": "villager"}
print(player["alive"])
上面這段 Python 值得看的是它有多「不必事先約定」:沒有 schema、沒有產生程式碼的步驟,resp.json() 回一個普通 dict,player["alive"] 靠字串鍵去取。方便,但也代表打錯鍵名要到執行期才知道,回應少了某個欄位也不會有人攔你。
// gRPC server stub in Go -- binary Protobuf frames over HTTP/2
func (s *server) Submit(ctx context.Context, a *pb.NightAction) (*pb.Ack, error) {
    log.Printf("actor=%d target=%d kind=%s", a.ActorId, a.TargetId, a.Kind)
    return &pb.Ack{Accepted: true}, nil
}
這段 Go 的差別是 a *pb.NightAction 是一個由 .proto 產生的具體型別:a.TargetId 是編譯期就存在的欄位,打錯名字專案根本編不過,型別也對死了。你用契約換來的,就是「錯誤在編譯期爆,不在半夜的生產環境爆」——代價是每次改 schema 都要重新產生兩端的程式碼、一起部署。
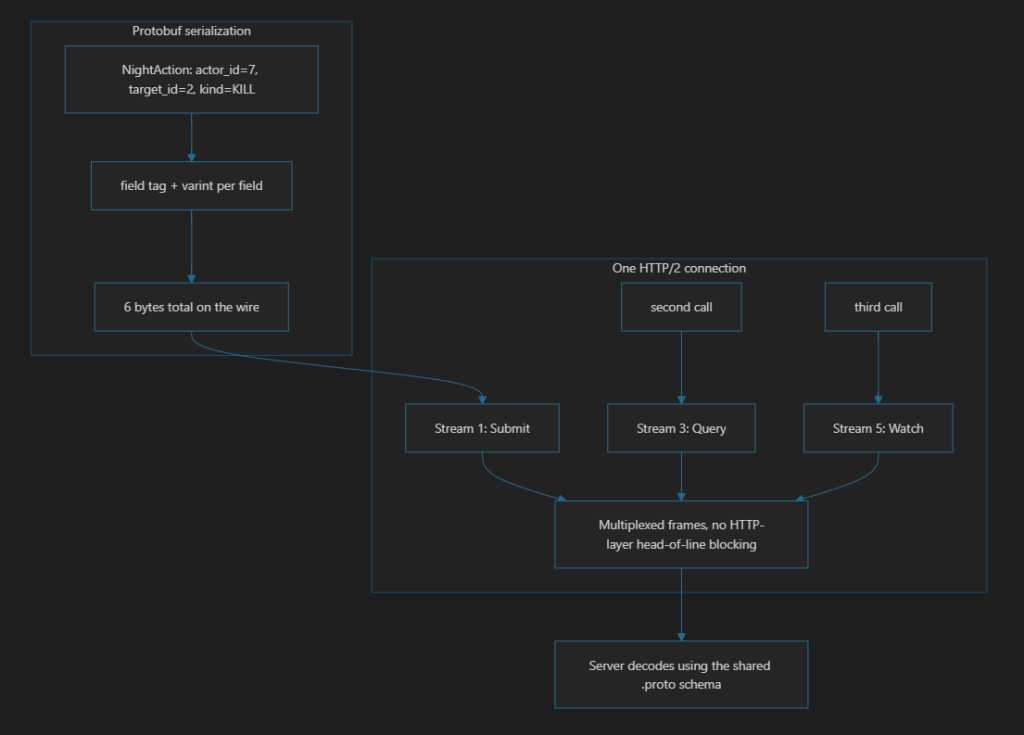
七號盯著兩欄看出來的,不只是效率差別。白天的話之所以冗長,是因為它預設會被回頭逐句審查,所以每個人都留餘地、都自描述、都把主詞講清楚;夜裡的動作之所以精簡到沒有字,是因為它只給共謀者看,而且夜殺本來就沒有遺言、不打算留下可審計的紀錄。JSON 是你不知道誰在聽的時候說的話,Protobuf 是你已經和對方對過暗號、連編號都背好之後打的手勢。選錯頻道的代價很具體:把對外的公開查詢硬套成 gRPC,外部呼叫端光是產生 stub、追著你的 schema 版本跑就得多繞一大圈;把系統內部的高頻溝通硬留在 REST,流量一大就先被 JSON 解析的 CPU 開銷和缺乏型別檢查拖垮。兩個頻道的落差本身,就是七號現在會拿來比對的東西——白天說了什麼是一回事,夜裡的手勢跟白天的說法對不對得上,又是另一回事。
讀完這篇,你該做的是自己寫一份 .proto,用 protoc 產生某個語言的 client 與 server stub,再拿同一個查詢分別用 curl 打一次 REST、用 gRPC 打一次,用抓包工具比較兩邊實際送出的位元組數;接著試著幫 .proto 加一個新欄位,看舊的 client 還能不能跟新的 server 通。Protobuf 官方 proto3 指南 有欄位編號與 schema 演進的權威說明,gRPC 官方核心概念文件 拆解了 stub 與雙向串流,RFC 9113 是 HTTP/2 多工與標頭壓縮的一手規格。
net/http 套件
REST JSON vs gRPC Protobuf wire format HTTP/2 multiplexing TCP head-of-line blocking protobuf field number schema evolution compatibility varint encoding cost json parsing overhead
¹ 註:本書名為情境設定之虛構文獻,非真實歷史或開源紀錄。


required vs optional 的歷史故事感謝 老大 在源來適你 Slack留言區提到這段——文章正文沒展開,這裡補一段。
proto2 其實有三種欄位規則:required、optional、repeated。required 聽起來很安心(型別系統幫你保證一定有值),但後來被 Google 自己列為 Protobuf 史上最有名的設計失誤之一:required 完全沒有向後相容的餘地。一旦某個欄位標成 required 上線,就永遠不能拿掉,也不能讓任何一端跳過它。只要有一邊——新 client/舊 server,或反過來——沒帶那個欄位,解析就會整包拒收(deserialization 直接失敗),而不是像正文寫的「默默用預設值跑錯」那種安靜失敗,是直接炸線上服務。
Protobuf 的技術負責人 Kenton Varda 公開講過這段歷史:Google 內部就吃過因為 required 欄位在多階段 rollout(新舊服務交錯上線)時沒配合好,導致服務中斷的苦頭。所以 proto2 官方 style guide 後來直接寫明:不要用 required。
proto3 索性把 required 整個拿掉,連 optional 關鍵字也一併拿掉——所有 singular 欄位預設全部視為隱含 optional,語義上退成「一律有預設值,讀不出對方到底有沒有明確設過」。這代表沒有 field presence:你分不出「對方真的傳了 0」還是「對方根本沒傳這個欄位」。結果又反過來被罵,因為有些場景(例如 PATCH 語義、三態 flag)真的需要知道「這欄位到底有沒有被明確設過」。
所以後來 proto3 又把 optional 關鍵字加回來,但做法不一樣:加了 optional 的 scalar 欄位在底層被包成一個隱藏的 oneof,透過 has_xxx() 去查存在與否,而不是回到 proto2 那種強制檢查。
// proto3 with explicit presence tracking
message NightAction {
  uint32 actor_id = 1;
  optional uint32 target_id = 2;   // has_target_id() now distinguishes "unset" from "set to 0"
  ActionKind kind = 3;
}
一句話總結:required 是「用型別系統把 schema evolution 的坑焊死」;proto3 先選擇整個放棄存在檢查換永久相容,後來再用 oneof 包裝把「有沒有設過」這個資訊局部找回來——但故意沒把 required 的強制力找回來,因為那個強制力正是讓它變成史上有名雷區的原因。
延伸閱讀:

 iThome鐵人賽
 看影片追技術